Bộ dữ liệu đánh giá LLM bao gồm đầu vào đại diện, hành vi mong đợi, tiêu chí rõ ràng và các trường hợp biên phản ánh rủi ro. Nên lấy ví dụ từ chuyên gia, phản hồi được phép sử dụng và tình huống tổng hợp; kiểm tra nhãn, phân tách tập phát triển và kiểm định, lưu phiên bản và bổ sung trường hợp mới sau khi phát hiện lỗi. Nhãn chuẩn cần được định nghĩa và kiểm tra nhất quán.
Mục lục
- Dataset đánh giá LLM là gì?
- Bắt đầu bằng mục tiêu đo
- Thu thập tình huống
- Thiết kế schema và nhãn
- Chọn grader và rubric
- Tách tập, versioning, tránh rò rỉ
- Ví dụ dataset phân loại ticket
- Câu hỏi thường gặp
- Nguồn tham khảo
Dataset đánh giá LLM là gì?
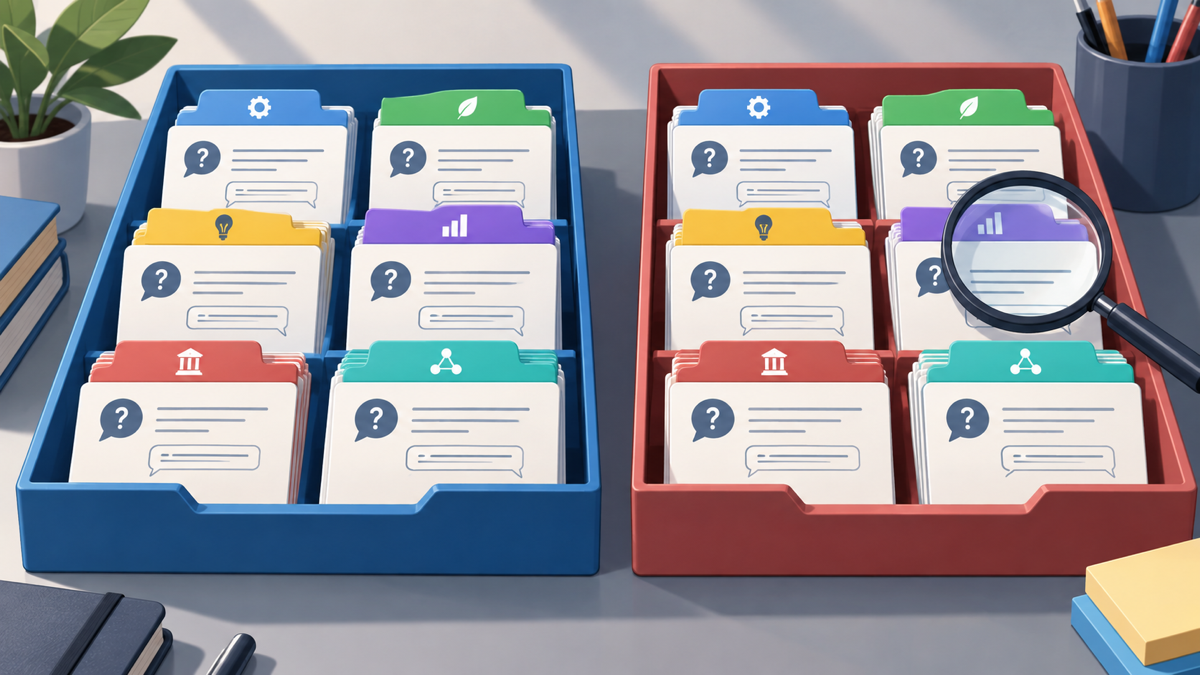
Bộ dữ liệu đánh giá LLM là tập hợp các tình huống có cấu trúc dùng để kiểm tra xem ứng dụng hoặc prompt có đáp ứng mục tiêu đã định hay không. Một dòng dữ liệu thường chứa đầu vào, ngữ cảnh cần thiết và một hoặc nhiều thông tin tham chiếu như nhãn đúng, nguồn bằng chứng, tiêu chí chấm hay các hành động được phép. Cấu trúc cụ thể phụ thuộc vào nhiệm vụ; phân loại ticket cần nhãn, còn trả lời câu hỏi từ tài liệu có thể cần nguồn và tiêu chí groundedness.
Dataset không tự tạo ra một phép đánh giá đúng. Nếu ví dụ không đại diện, nhãn sai, hoặc metric không liên quan đến chất lượng người dùng cần, điểm số cao vẫn có thể gây hiểu lầm. Hãy xác định trước điều gì khiến kết quả được chấp nhận và lỗi nào không thể chấp nhận được.
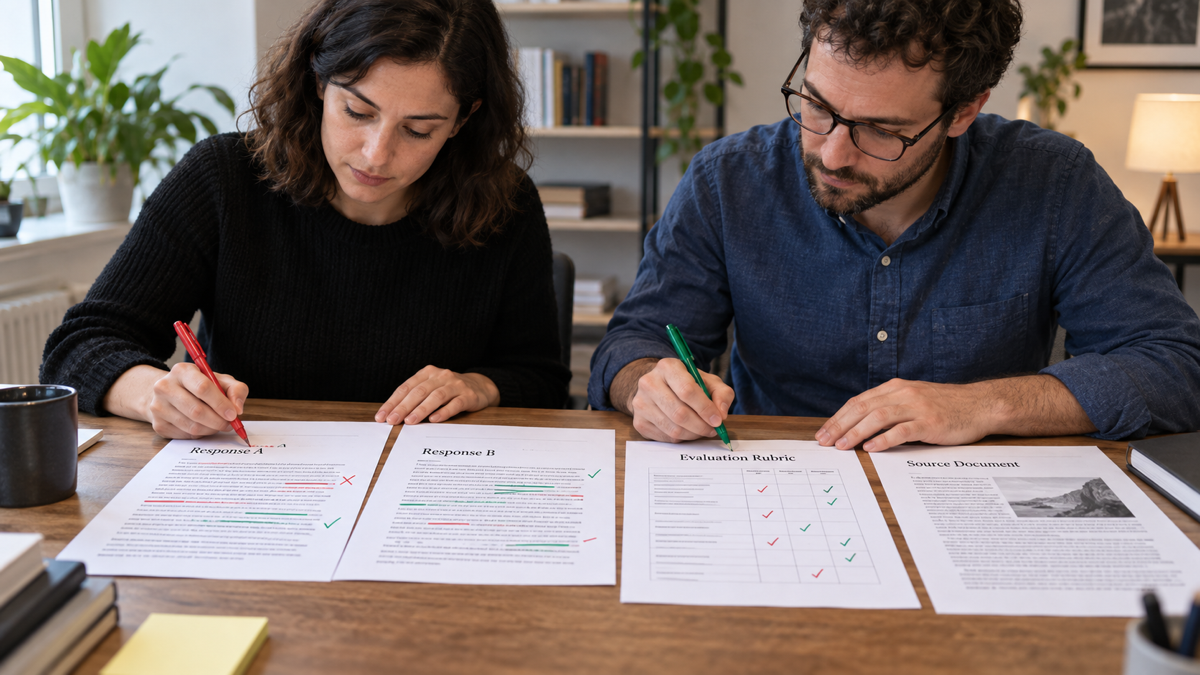
OpenAI Docs mô tả quy trình đánh giá bao gồm xác định mục tiêu, thu thập dataset, định nghĩa metric, thực hiện so sánh và đánh giá liên tục. Hướng dẫn cũng khuyên bao gồm tình huống thường gặp, edge case và adversarial case, kết hợp dữ liệu chuyên gia, dữ liệu lịch sử và phản hồi phù hợp. Các con số ví dụ trong tài liệu không phải là ngưỡng chuẩn cho mọi sản phẩm; nhóm phải tự đặt tiêu chí theo tác vụ.
Bắt đầu bằng mục tiêu đo
Viết mục tiêu dưới dạng hành vi quan sát được. “Model thông minh hơn” không phải là mục tiêu có thể kiểm thử; “phân loại yêu cầu vào đúng một trong năm nhóm, không bịa nhãn ngoài danh mục” cụ thể hơn. Với trợ lý hỏi đáp nội bộ, mục tiêu có thể bao gồm trả lời đúng theo tài liệu, nêu nguồn, từ chối khi không đủ căn cứ và không lộ thông tin ngoài quyền.
Liệt kê cả mục tiêu tích cực lẫn điều cần chặn. Hệ thống tóm tắt cần giữ ý chính nhưng cũng không được tự thêm con số. Bộ trích xuất cần định dạng ổn định nhưng phải đánh dấu thiếu dữ liệu thay vì bịa. Bộ phân loại cần đúng nhãn và xử lý “không chắc” theo chính sách.
Lập taxonomy lỗi
Phân loại lỗi theo hậu quả giúp dataset tập trung vào rủi ro thay vì thu thập quá nhiều mẫu tương tự. Với bot hỗ trợ khách hàng, taxonomy có thể bao gồm sai chính sách, thiếu thông tin, trả lời ngoài phạm vi, tiết lộ dữ liệu, sai định dạng, hành động không được phép và câu hỏi mơ hồ. Mỗi lỗi nên có định nghĩa, ví dụ dương/âm và mức độ nghiêm trọng. Nhóm vận hành hoặc chuyên gia nghiệp vụ cần rà soát taxonomy trước khi gắn nhãn hàng loạt.
Đặt đơn vị đánh giá: một lời gọi, một lượt hội thoại, một quy trình nhiều bước hay một trace agent. Nếu chỉ chấm câu cuối, bạn có thể bỏ lỡ lỗi gọi tool sai dù câu trả lời sau đó nghe có vẻ đúng. Với quy trình agent, lưu các bước liên quan như tool được chọn, tham số, phản hồi và trạng thái cuối theo chính sách dữ liệu.
Thu thập tình huống đại diện
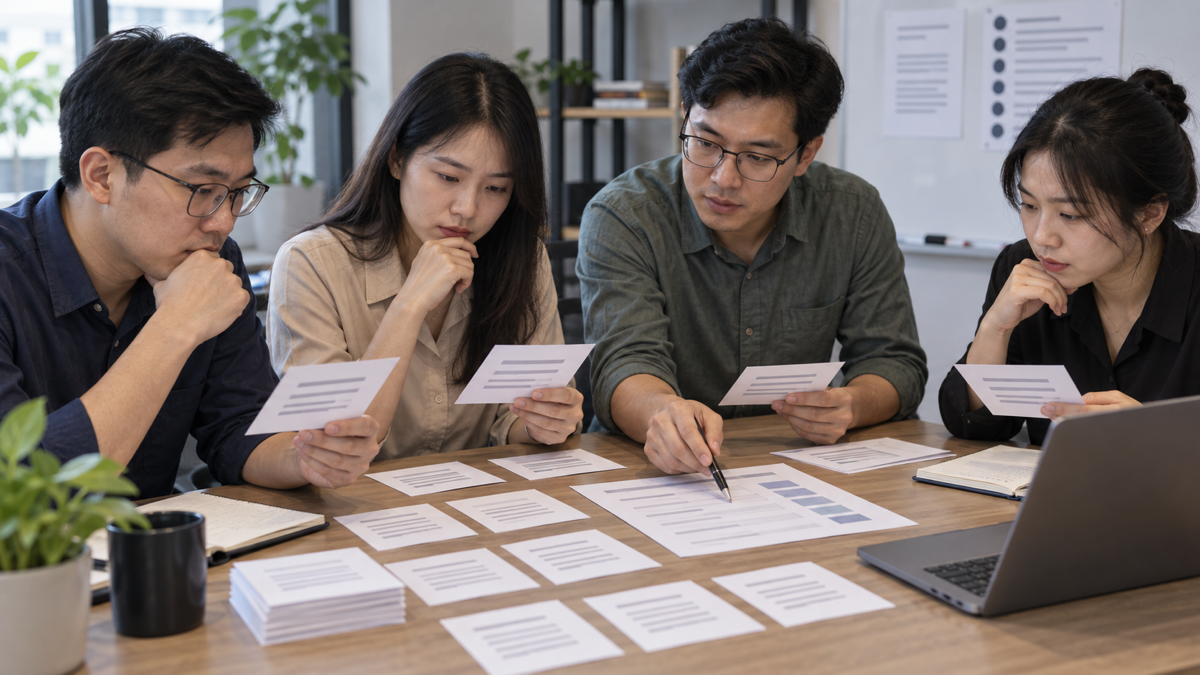
Nguồn dữ liệu có thể là các trường hợp do chuyên gia viết, lịch sử đã được phép dùng, phản hồi người dùng, báo cáo sự cố hoặc trường hợp tổng hợp có kiểm tra. Mỗi nguồn có thiên lệch riêng: log thường phản ánh người dùng hiện tại và các trường hợp đã xảy ra, còn ví dụ viết tay có thể bỏ qua ngôn ngữ đời thường hoặc lỗi bất ngờ. Kết hợp nguồn giúp tăng độ phủ nhưng phải ghi lại provenance, mục đích sử dụng và điều kiện quyền riêng tư.
Chọn mẫu theo các lát cắt quan trọng: ý định, ngôn ngữ, độ dài, chất lượng dữ liệu, mức rủi ro, nhóm người dùng, tình huống thiếu ngữ cảnh và loại công cụ. Đếm số mẫu tổng thể không đủ; hãy kiểm tra phân bố và nhóm hiếm nhưng hậu quả cao. Không cân bằng dataset một cách mù quáng nếu điều đó làm sai tần suất thực tế; thay vào đó báo cáo điểm theo nhóm và giữ tập kiểm định phản ánh mục tiêu sử dụng.