RAG là một trong những kỹ thuật phổ biến khi xây dựng ứng dụng AI cần trả lời dựa trên tài liệu, cơ sở tri thức hoặc dữ liệu bên ngoài mô hình. RAG (Retrieval-Augmented Generation) là kỹ thuật kết hợp truy xuất thông tin với khả năng sinh nội dung của mô hình ngôn ngữ. Khi nhận câu hỏi, hệ thống sẽ tìm dữ liệu liên quan, đưa dữ liệu đó vào context, sau đó mới yêu cầu LLM tạo câu trả lời. Có thể hiểu RAG qua ba bước chính: retrieval – context – generation. RAG kết hợp truy xuất dữ liệu với khả năng sinh nội dung của LLM.
RAG là gì trong AI?
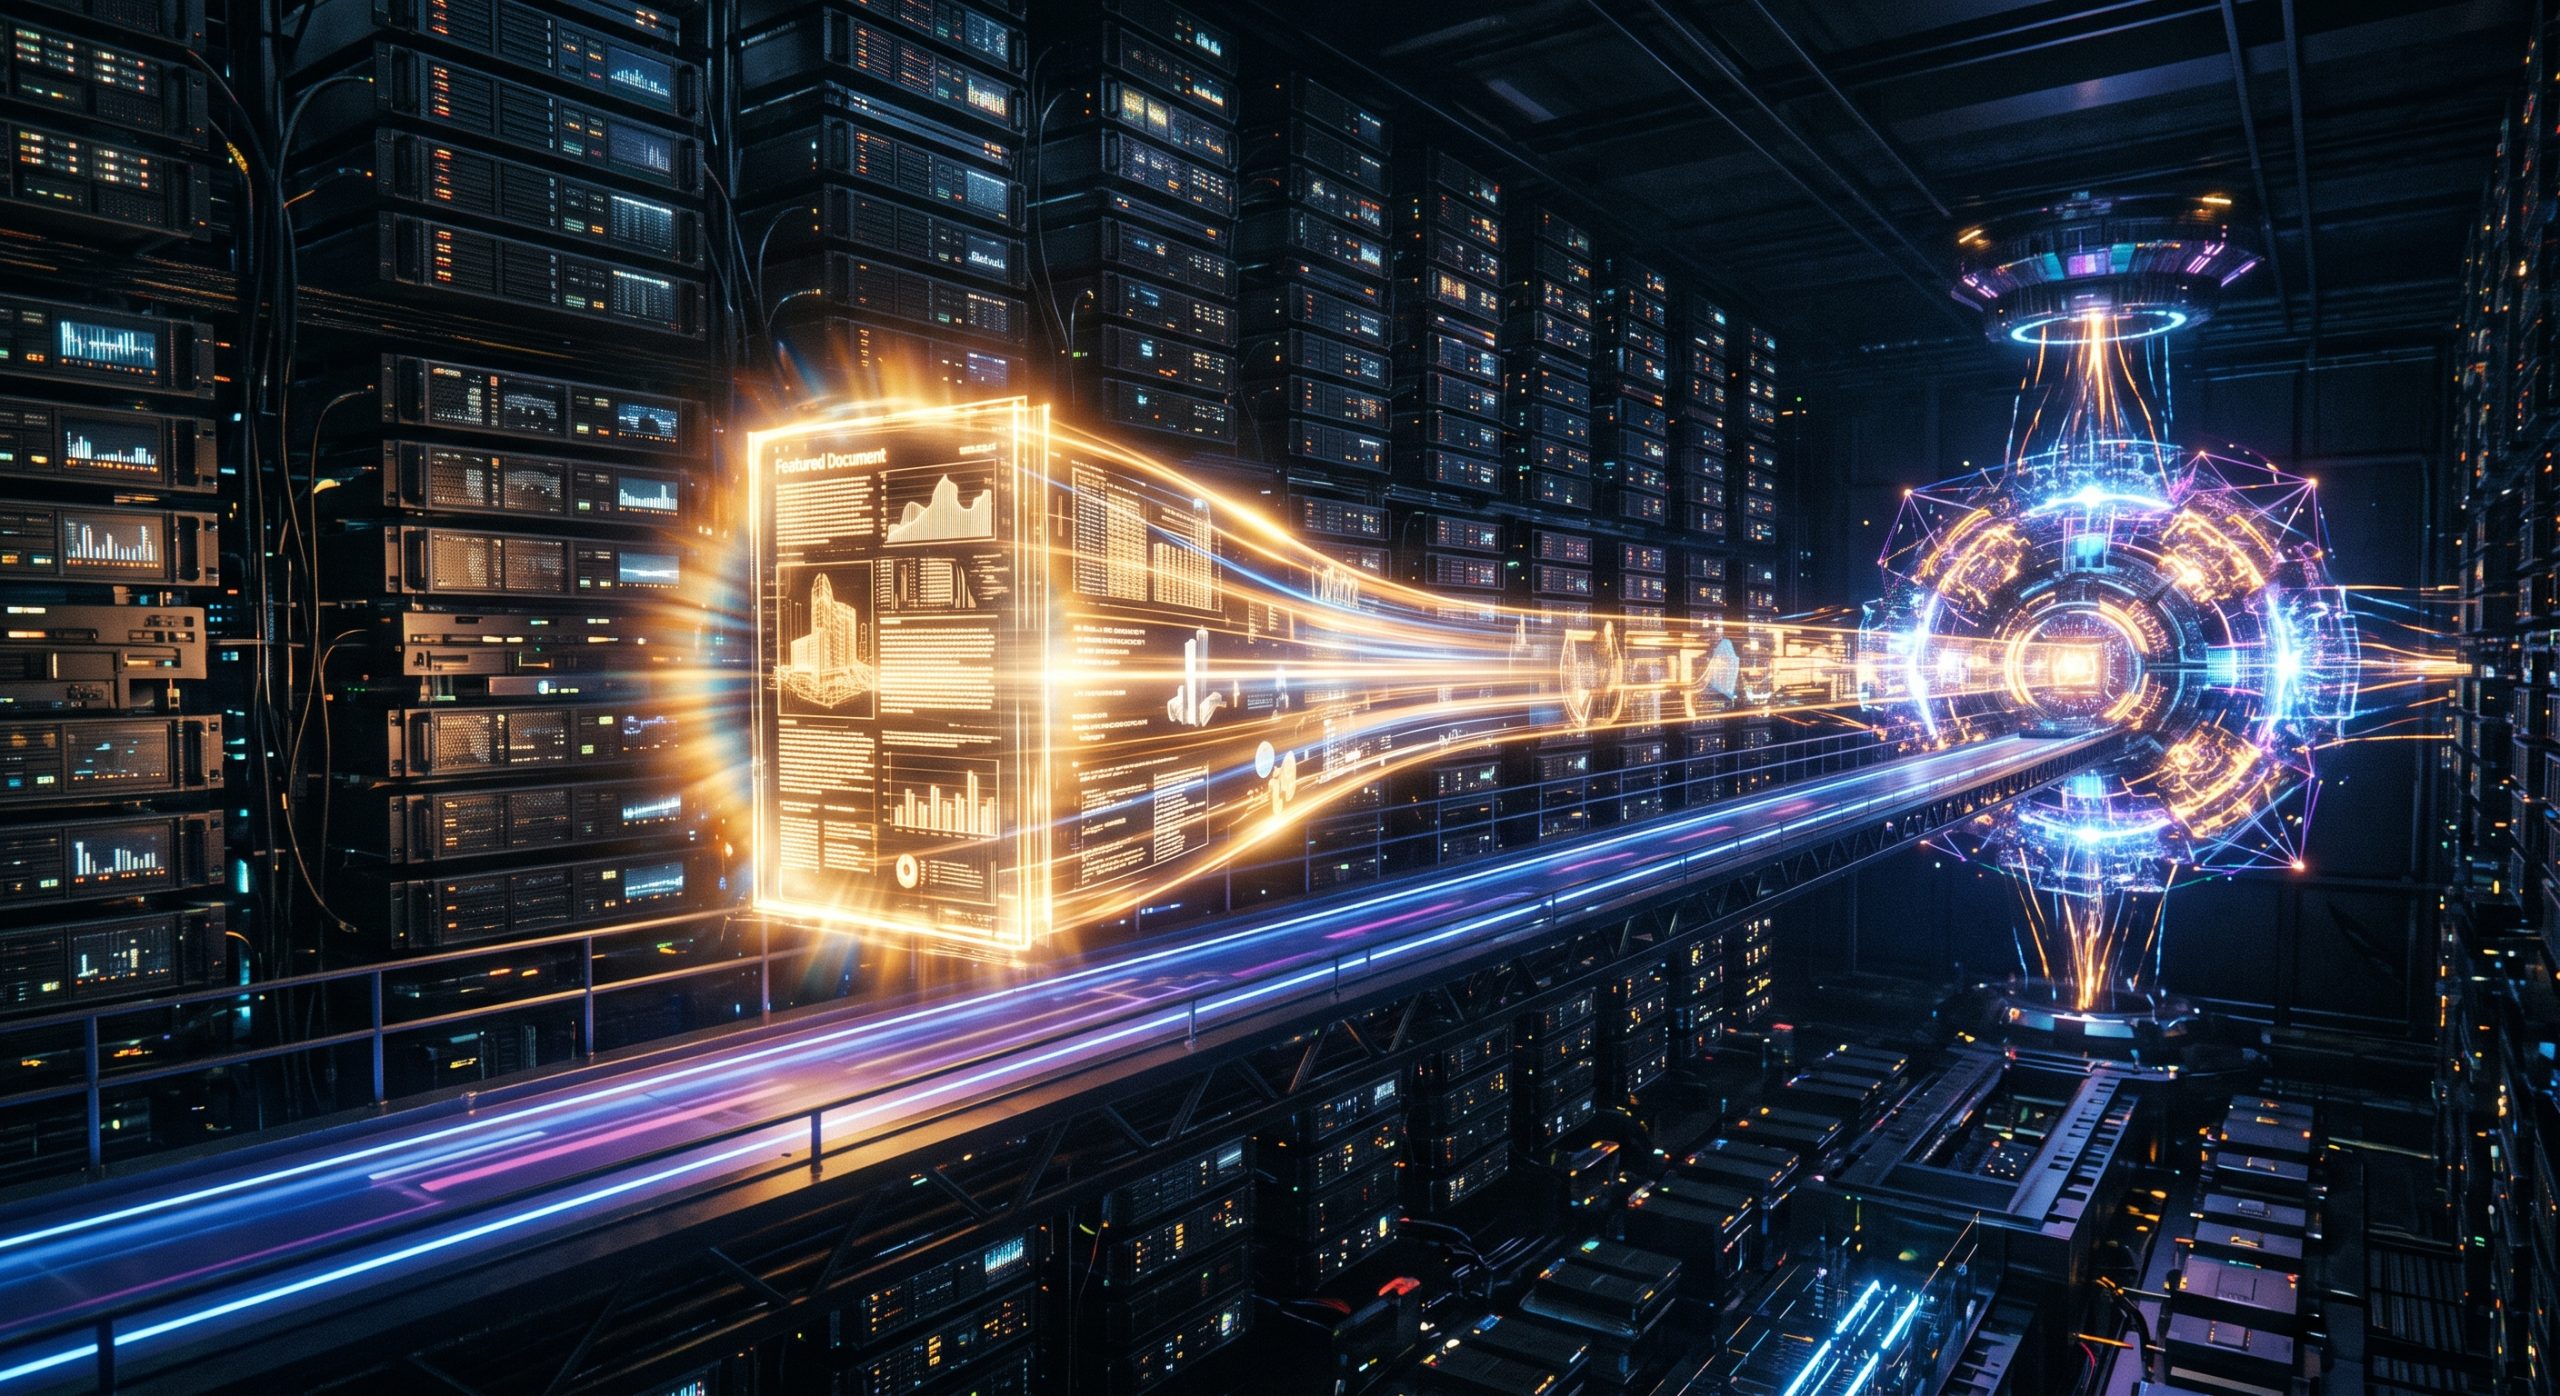
Mô hình ngôn ngữ lớn có thể trả lời dựa trên kiến thức đã học trong quá trình huấn luyện, nhưng không mặc nhiên biết mọi tài liệu nội bộ hoặc thông tin mới phát sinh. RAG bổ sung một lớp truy xuất bên ngoài. Thay vì gửi câu hỏi trực tiếp cho LLM, hệ thống tìm các tài liệu liên quan trước, sau đó cung cấp chúng cùng câu hỏi cho mô hình. Ví dụ, một doanh nghiệp có kho tài liệu về sản phẩm, quy trình hoặc chính sách. Khi người dùng đặt câu hỏi, hệ thống RAG có thể tìm đúng phần tài liệu liên quan rồi dùng phần đó làm căn cứ để tạo câu trả lời. Điểm quan trọng là RAG không yêu cầu huấn luyện lại mô hình mỗi khi dữ liệu thay đổi. Kiến thức có thể được cập nhật ở nguồn bên ngoài và truy xuất khi cần.
Một hệ thống RAG gồm những thành phần nào?
Về logic, hệ thống RAG thường có ba phần chính.
- Retrieval: tìm dữ liệu liên quan. Retrieval là bước tìm nội dung phù hợp với câu hỏi. Nguồn dữ liệu có thể là tài liệu nội bộ, hướng dẫn kỹ thuật, cơ sở tri thức hoặc các nguồn mà hệ thống được phép truy cập. Trong nhiều hệ thống, tài liệu được chia thành các đoạn nhỏ gọi là chunk. Nội dung có thể được biểu diễn bằng embedding và lưu trong vector database để hỗ trợ semantic search. Khi người dùng đặt câu hỏi, retriever tìm các đoạn phù hợp nhất để đưa sang bước tiếp theo. Nếu retrieval chọn sai tài liệu, LLM sẽ nhận context không phù hợp và câu trả lời dễ sai theo.
- Context: cung cấp thông tin cho mô hình. Các đoạn được truy xuất sẽ được đưa vào context cùng câu hỏi. Context cần đủ thông tin để mô hình trả lời nhưng không nên chứa quá nhiều dữ liệu không liên quan. Nếu context quá dài hoặc nhiễu, mô hình có thể khó xác định đâu là thông tin quan trọng. Vì vậy, chất lượng của chunking, filtering và reranking có ảnh hưởng đáng kể đến hiệu quả RAG.
- Generation: tạo câu trả lời. Ở bước cuối, LLM sử dụng câu hỏi và context để tạo phản hồi. Hệ thống có thể yêu cầu mô hình chỉ dựa trên dữ liệu được cung cấp, trả lời “không đủ thông tin” khi thiếu bằng chứng hoặc hiển thị nguồn tham chiếu. RAG giúp cung cấp căn cứ tốt hơn cho mô hình nhưng không đảm bảo loại bỏ hoàn toàn hallucination. Retrieval cung cấp thông tin liên quan trước khi LLM tạo câu trả lời.
RAG hoạt động như thế nào?
Một quy trình RAG cơ bản gồm:
- Người dùng gửi câu hỏi.
- Hệ thống tìm dữ liệu liên quan.
- Các đoạn tài liệu phù hợp được lựa chọn.
- Nội dung được đưa vào context.
- LLM tạo câu trả lời.
- Kết quả được trả cho người dùng, có thể kèm nguồn tham chiếu.
Nhìn từ phía người dùng, phần dễ thấy nhất là câu trả lời cuối cùng. Nhưng chất lượng của câu trả lời phụ thuộc vào cả pipeline. Nếu tài liệu lỗi thời, retrieval chọn sai nội dung hoặc context thiếu thông tin, LLM có thể trả lời không chính xác dù bản thân mô hình vẫn hoạt động đúng theo dữ liệu nhận được.
Vì sao RAG được dùng cùng LLM?
Kết nối AI với dữ liệu riêng: RAG phù hợp khi AI cần làm việc với dữ liệu không nằm trong kiến thức chung của mô hình, chẳng hạn tài liệu nội bộ hoặc cơ sở tri thức chuyên ngành. Thay vì kỳ vọng LLM “biết sẵn”, hệ thống truy xuất dữ liệu khi có truy vấn.
Cập nhật kiến thức linh hoạt hơn: Nếu dữ liệu thường xuyên thay đổi, duy trì nguồn kiến thức bên ngoài giúp hệ thống linh hoạt cập nhật hơn.